Dokazi, sledljivost in forenzika
KO OSEM ZNAKOV ODLOČA O IDENTITETI DATOTEKE
Paradoks rojstnih dni, skrajšani SHA-256 in tveganje napačnega ujemanja
Ko dokument prispe v informacijski sistem, aplikacija izračuna njegovo zgoščeno vrednost SHA-256. Rezultat v šestnajstiškem zapisu obsega 64 znakov, razvijalec pa se zaradi preprostejšega shranjevanja in primerjanja odloči uporabiti samo prvih osem. Poenostavitev se zdi razumna, saj tudi tako skrajšana vrednost omogoča več kot štiri milijarde različnih kombinacij. Zamislimo si, da aplikacija postopoma prejme 100.000 različnih dokumentov. Če so njihove skrajšane zgoščene vrednosti porazdeljene približno enakomerno in neodvisno, obstaja skoraj 69-odstotna verjetnost, da bosta vsaj dva dokumenta dobila enak osemmestni odtis.
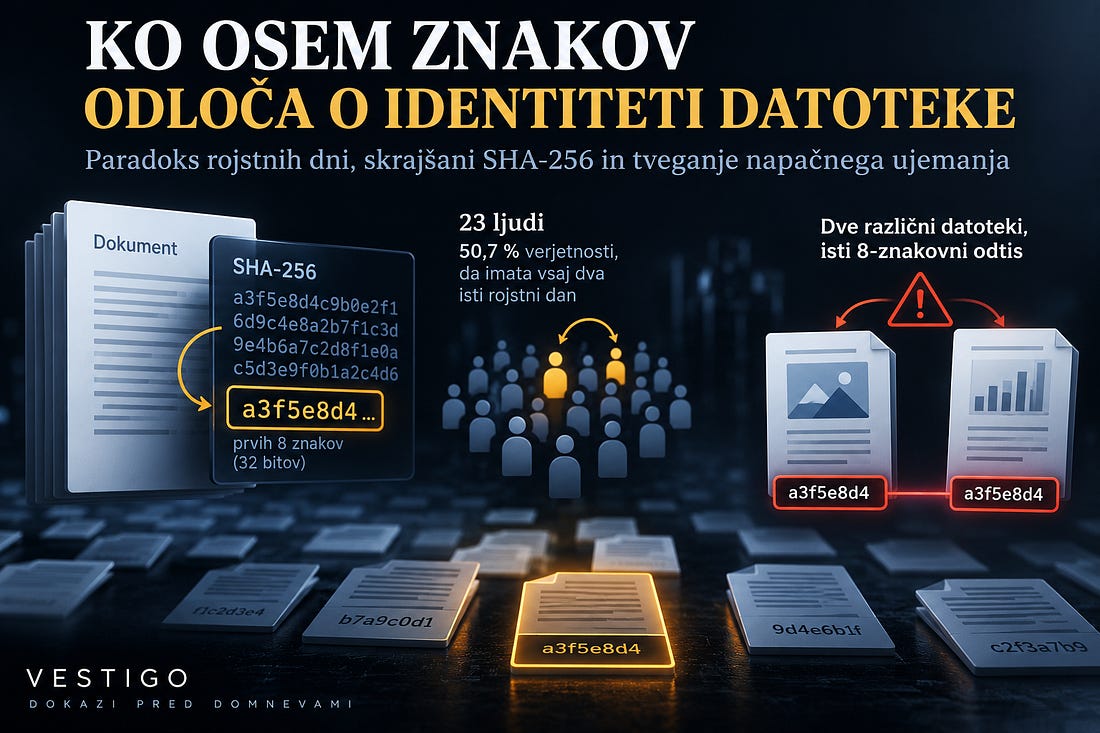
Algoritem SHA-256 pri tem deluje pravilno. Težava se lahko pojavi, če aplikacija skrajšano vrednost uporablja kot dokončen dokaz, da sta dokumenta enaka. Zaradi ujemanja lahko novo datoteko označi kot podvojeno, jo poveže z napačnim zapisom ali preskoči njeno nadaljnjo obdelavo. Ali bo do takšne napake dejansko prišlo, je odvisno od implementacije.
Skoraj 69-odstotna verjetnost ujemanja je morda presenetljiva, saj govorimo o več kot štirih milijardah možnih vrednosti. Pojasnilo najdemo v matematičnem pojavu, ki ga lahko razumemo že s pomočjo rojstnih dni.
Zakaj je dovolj že 23 ljudi
V prostoru se zbere 23 ljudi. Vsak pove svoj rojstni datum, zanima pa nas, ali sta se vsaj dva rodila na isti dan v letu. Za izračun zanemarimo 29. februar in predpostavimo, da ima vseh preostalih 365 datumov enako verjetnost.
Triindvajset ljudi ob 365 možnih datumih rojstva ne daje občutka velike verjetnosti ujemanja. Običajno namreč razmišljamo o možnosti, da ima nekdo rojstni dan na isti datum kot ena vnaprej izbrana oseba, pri čemer spregledamo vse druge pare, ki lahko nastanejo v skupini.
Če rojstni dan izbrane osebe primerjamo z rojstnimi dnevi preostalih 22, preverjamo 22 možnosti. Ko iščemo ujemanje med katerimikoli dvema osebama, pa moramo upoštevati vse možne pare. Pri 23 ljudeh jih je 253, saj velja 23 × 22 / 2 = 253. Verjetnost vsaj enega ujemanja zato narašča presenetljivo hitro. Pri desetih ljudeh znaša približno 11,7 odstotka, pri dvajsetih 41,1 odstotka in pri triindvajsetih že 50,7 odstotka. Če se skupina poveča na petdeset ljudi, doseže približno 97 odstotkov.
Pojav imenujemo paradoks rojstnih dni, čeprav v njem ni matematičnega protislovja. Presenetljivo je predvsem to, kako pogosto pri intuitivni presoji spregledamo število vseh možnih primerjav.
Podobno se dogaja pri zgoščenih vrednostih. Kadar primerjamo veliko množico podatkov, se možnost ujemanja katerihkoli dveh rezultatov povečuje bistveno hitreje, kot bi sklepali samo iz števila razpoložljivih vrednosti. Pri tem ni treba predpostaviti, da so vse primerjave med pari neodvisni dogodki; izračun verjetnosti upošteva celotno množico.
Kaj ostane od SHA-256, če uporabimo samo osem znakov
Kriptografska zgoščevalna funkcija iz vhodnih podatkov izračuna vrednost določene dolžine. Pri SHA-256 rezultat obsega 256 bitov, kar v šestnajstiškem zapisu predstavlja 64 znakov. Isti vhod vedno ustvari enak rezultat, že majhna sprememba podatkov pa praviloma povzroči drugačno zgoščeno vrednost.
Takšne funkcije imajo pomembno vlogo pri preverjanju integritete datotek, digitalnih podpisih in drugih postopkih, pri katerih mora računalniški sistem razlikovati med podatki.
Polni SHA-256 ima 2256 možnih rezultatov, približno 1,16 × 1077 različnih vrednosti. Njegova odpornost proti generičnemu iskanju trkov je v klasičnem računskem modelu ocenjena na 128 bitov, kar za običajne praktične namene pomeni izjemno visoko računsko zahtevnost [1].
V našem primeru aplikacija od teh 256 bitov ohrani samo prvih 32. Osem šestnajstiških znakov namreč predstavlja 32 bitov, s čimer se prostor možnih rezultatov zmanjša na 232 oziroma 4.294.967.296 vrednosti.
Število je še vedno veliko, vendar paradoks rojstnih dni pokaže, zakaj samo velikost prostora možnih rezultatov ni dovolj za presojo verjetnosti ujemanja.
Pri približno 77.163 neodvisnih in enakomerno porazdeljenih 32-bitnih rezultatih doseže verjetnost vsaj enega trka približno 50 odstotkov. Če število rezultatov povečamo na 100.000, naraste na približno 68,8 odstotka.
Za približen izračun uporabimo rojstnodnevno aproksimacijo:
P ≈ 1 − exp(−n(n−1)/(2 × 2³²))
Pri tem n predstavlja število različnih vhodov, izraz pa ocenjuje možnost, da se med njihovimi skrajšanimi zgoščenimi vrednostmi pojavi vsaj eno ujemanje.
Rezultat je precej drugačen, če imamo en vnaprej določen 32-bitni odtis in iščemo ujemanje med 100.000 neodvisnimi poskusi. Verjetnost, da vsaj eden zadene izbrano vrednost, znaša približno 0,0023 odstotka.
Razlika med 68,8 odstotka in 0,0023 odstotka izhaja iz narave problema. Pri prvem nas zanima poljuben ujemajoči se par, pri drugem pa poskušamo zadeti točno določeno vrednost. V kriptografiji ima to razlikovanje neposredne posledice za ocenjevanje zahtevnosti napadov.
Trk ni isto kot ponaredek
Zgoščevalne funkcije sprejemajo zelo veliko množico različnih vhodnih podatkov, vračajo pa rezultate omejene dolžine. Zato morajo obstajati različni vhodi, ki ustvarijo enako zgoščeno vrednost. Takšno ujemanje imenujemo trk oziroma kolizija. Pri varni kriptografski funkciji obstoj trkov ni nepričakovana napaka. Pomembno je, da jih je z razpoložljivo računsko zmogljivostjo izjemno težko namenoma poiskati.
Pri idealizirani 256-bitni funkciji je zahtevnost generičnega iskanja poljubnega para različnih vhodov z enako zgoščeno vrednostjo reda 2128 izračunov. NIST zato za SHA-256 navaja pričakovano 128-bitno odpornost proti trkom [1].
Zahtevnejši je praviloma problem, pri katerem ima napadalec že določeno datoteko in mora poiskati drugo z enakim odtisom. Takšen postopek imenujemo napad na drugo predsliko (second-preimage attack). Pri SHA-256 je generična računska zahtevnost iskanja druge predslike za kratka sporočila približno 2256 poskusov. Pri zelo dolgih sporočilih lahko posebne metode zmanjšajo pričakovano zahtevnost, zato je treba pri natančni varnostni oceni upoštevati tudi dolžino vhodnih podatkov [1].
Razlikovanje je pomembno pri digitalnih podpisih, saj ima napadalec, ki lahko vnaprej pripravi oba dokumenta, drugačne možnosti od nekoga, ki poskuša naknadno spremeniti že podpisan, vnaprej določen dokument. Uspešno iskanje poljubnega trka zato samo po sebi ne omogoča ponarejanja kateregakoli obstoječega podpisa. Za izkoriščanje so pomembni podpisna shema, način priprave podatkov in nadzor, ki ga ima napadalec nad vhodnimi dokumenti.
Pri starejših zgoščevalnih funkcijah so raziskovalci odkrili slabosti, zaradi katerih je mogoče trke izdelati bistveno hitreje od generičnih metod. Med najbolj znanimi javno predstavljenimi primeri je SHA-1, pri katerem se je dolgo znana teoretična ranljivost razvila v praktično izvedljiv napad.
Dva različna dokumenta PDF z enakim SHA-1
Februarja 2017 so raziskovalci nizozemskega inštituta CWI in Googla predstavili projekt SHAttered. Pripravili so dve različni datoteki PDF z enako zgoščeno vrednostjo SHA-1, čeprav sta prikazovali različno vsebino.
Sistem, ki bi za razlikovanje med njima uporabil izključno SHA-1, bi ju prepoznal kot enaka na ravni tega odtisa. Raziskovalci so tako prvič javno demonstrirali praktično izdelan trk za celotni SHA-1 [2].
Napad je zahteval približno 9,22 × 10¹⁸ izračunov SHA-1. Raziskovalna skupina je računsko zahtevnost prve faze primerjala s približno 6.500 leti dela ene procesorske enote, druge pa s približno 110 leti dela enega grafičnega procesorja. Izračuni so potekali vzporedno na obsežni infrastrukturi, zato navedene vrednosti opisujejo skupno računsko delo, ne dejanskega trajanja napada.
Kljub takšni zahtevnosti je bila uporabljena metoda več kot stotisočkrat učinkovitejša od generičnega iskanja trka. Slabost SHA-1 je s tem postala praktično demonstriran kriptografski problem.
Leta 2020 sta Gaëtan Leurent in Thomas Peyrin objavila raziskavo praktičnega napada z izbranima predponama (chosen-prefix collision). Ta omogoča izdelavo dveh sporočil z različnima, vnaprej izbranima začetnima deloma, ki jima je mogoče dodati ustrezne podatke, da dobita enako končno zgoščeno vrednost.
Raziskovalca sta posledice pokazala na infrastrukturi PGP oziroma GnuPG. Pripravila sta par ključev z različnima identitetama, vendar s certifikacijskima podatkoma, ki sta ustvarila enako vrednost SHA-1. Zaradi tega je bilo mogoče certifikacijski podpis, izdan za en ključ, uporabiti pri drugem in prikazati možnost lažnega predstavljanja identitete [3].
Takšen napad je posebej pomemben pri podpisnih postopkih, kjer lahko napadalec nadzoruje pripravo obeh vhodnih sporočil. Če mu uspe ustvariti ustrezen par z enako zgoščeno vrednostjo, lahko ranljiv protokol omogoči prenos podpisa med njima.
Demonstrirana napada pa ne dokazujeta, da lahko nekdo poljubnemu že podpisanemu dokumentu spremeni vsebino in obdrži veljaven podpis. Njuna izvedljivost je odvisna od vrste trka, možnosti priprave sporočil in konkretne uporabe kriptografskega algoritma.
Raziskavi sta pomembni predvsem zato, ker sta pokazali dejanske posledice uporabe SHA-1 v postopkih, ki zahtevajo odpornost proti trkom. Pri takšnih postopkih pravilno delovanje podpisne programske opreme ne zadostuje, če uporabljeni kriptografski gradnik ne zagotavlja več pričakovane zaščite.
Napaka, za katero napadalec sploh ni potreben
Projekt SHAttered je zahteval zahtevno kriptoanalizo in obsežno računsko infrastrukturo. Pri naši izmišljeni aplikaciji z osemmestnim odtisom pa lahko težava nastane med povsem običajno obdelavo podatkov, brez napada ali namernega spreminjanja dokumentov.
Recimo, da dokumentni sistem uporablja skrajšano vrednost za zaznavanje podvojitev. Ob prejemu nove datoteke izračuna prvih osem znakov SHA-256 in preveri, ali enak odtis že obstaja. Če ga najde, datoteko označi kot podvojeno in nadaljnjo obdelavo preskoči.
Ko se zbirka povečuje, raste tudi verjetnost, da bosta dve različni datoteki dobili enak skrajšani odtis. Če aplikacija ob takšnem ujemanju brez dodatnega preverjanja odloči, da gre za isto datoteko, lahko zavrne dokument, ki ga še ni obdelala, ga poveže z napačnim zapisom ali prepreči njegovo shranjevanje.
Posledice so odvisne od namena aplikacije. V osebni zbirki fotografij lahko takšno ujemanje povzroči napačno prepoznan dvojnik, v poslovnem dokumentnem sistemu pa vpliva na evidentiranje ali nadaljnjo obdelavo dokumenta. Če se skrajšani odtis uporablja še za odločitve o dostopu, odobritvi ali zaupanju, lahko napačno ujemanje povzroči tudi varnostne posledice. Njihova dejanska resnost je odvisna od pravil, po katerih sistem obdeluje podatke.
Napaka je preprečljiva brez zamenjave SHA-256. Skrajšano vrednost lahko uporabimo za hitro iskanje možnih ujemanj, nato pa primerjamo celotno zgoščeno vrednost in po potrebi tudi vsebino datotek. V takšni zasnovi ujemanje kratkih odtisov še ne povzroči dokončne odločitve, da sta dokumenta enaka.
Razlikovati je treba tudi med prikazom vrednosti in njeno dejansko uporabo. Aplikacija lahko uporabniku zaradi preglednosti pokaže samo prvih osem znakov, medtem ko v podatkovni zbirki hrani vseh 256 bitov. Če se primerjave in pomembne odločitve izvajajo na podlagi celotne vrednosti, takšen krajši prikaz ne zmanjša kriptografske odpornosti uporabljenega algoritma.
Povsem drugače je, kadar aplikacija celotnega rezultata sploh ne shrani in osemmestni odtis uporablja kot edino merilo za identifikacijo dokumenta. S tem bistveno omeji število različnih vrednosti, na katerih temeljijo njene odločitve, čeprav bi uporabljeni algoritem omogočal veliko večji prostor rezultatov.
Z vidika razvoja programske opreme je to pomembna razlika. Kriptografska funkcija lahko zagotavlja predvidene varnostne lastnosti, aplikacija pa jih s svojo zasnovo ne izkoristi.
Algoritem lahko deluje tudi potem, ko ni več primeren
Pri SHA-1 je položaj nekoliko drugačen. Starejša aplikacija lahko algoritem še vedno pravilno izvaja, vendar njegova odpornost proti trkom ne ustreza več zahtevam za nove digitalne podpise. NIST je že leta 2006 priporočil prehod s SHA-1 na SHA-2 pri aplikacijah, ki potrebujejo odpornost proti trkom. Leta 2011 je dodatno opredelil omejitve uporabe SHA-1 pri ustvarjanju novih digitalnih podpisov [4].
Decembra 2022 je objavil načrt nadaljnjega umika SHA-1 iz kriptografskih aplikacij do 31. decembra 2030. Gre za časovnico znotraj NIST-ovega standardizacijskega in validacijskega okvira, ne za splošno zakonsko prepoved, ki bi na ta dan samodejno veljala za vsak informacijski sistem na svetu.
NIST za ustrezne nove uporabe priporoča algoritme iz družin SHA-2 in SHA-3. Ob tem izrecno navaja, da ni potrebe po splošni zamenjavi varno uporabljene družine SHA-2 z družino SHA-3 [5].
Tudi uporabe SHA-1 niso vse enakovredne. Slabosti pri odpornosti proti trkom imajo drugačne posledice za digitalne podpise kot za nekatere konstrukcije HMAC, ki temeljijo na drugih varnostnih lastnostih. Ocena mora zato vključevati konkretni algoritem, način uporabe in varnostne zahteve.
Za upravljavce informacijskih sistemov je pomembno predvsem poznavanje dejanske uporabe kriptografskih mehanizmov. Algoritem je lahko določen v aplikacijski kodi, starejši knjižnici, podpisnem postopku ali protokolu, ki ga vzdržuje zunanji ponudnik. Brez takšnega pregleda je težko ugotoviti, katere sisteme je treba prilagoditi in kakšne posledice bi lahko imela sprememba.
Pri zamenjavi je treba upoštevati tudi zgodovinske podatke in dokumente. Starejši digitalni podpisi, časovni žigi ali drugo zaščiteno gradivo lahko zahtevajo posebne postopke preverjanja, tudi ko uporaba prvotnega algoritma za ustvarjanje nove zaščite ni več primerna.
V večjih informacijskih okoljih se zato prehod na novejši algoritem pogosto dotakne združljivosti, dolgoročne hrambe dokumentov, preverjanja obstoječih podpisov in usklajevanja z zunanjimi ponudniki. Tehnična sprememba je lahko majhna, njen vpliv na delovanje povezanih sistemov pa precej širši.
Osem znakov ni dokaz enakosti
Pri pregledu dokumentnega sistema je smiselno najprej ugotoviti, kako prepoznava posamezne datoteke. Pomembno je, katere identifikatorje uporablja, koliko podatkov dejansko shrani in ali ujemanje zgoščenih vrednosti obravnava kot predhodno informacijo ali kot dokončen dokaz enakosti.
Za enolično označevanje zapisov so lahko primernejši namenski identifikatorji z ustreznim načinom zagotavljanja enoličnosti. Pri preverjanju vsebinske enakosti pa imajo svoje mesto kriptografske zgoščene vrednosti primerne dolžine, dopolnjene z neposredno primerjavo podatkov, kadar jo namen sistema zahteva.
Pri digitalnih podpisih je treba poleg odpornosti zgoščevalne funkcije upoštevati še uporabljeno podpisno shemo, veljavnost ključev in certifikatov ter način priprave podpisanih podatkov. Pri zaznavanju podvojenih datotek so lahko zahteve drugačne, vendar mora biti odločitev o enakosti objektov še vedno utemeljena z dovolj zanesljivim postopkom.
Raziskovalci so za praktičen trk v SHA-1 potrebovali leta razvoja metod in ogromno računske zmogljivosti. Pri aplikaciji, ki SHA-256 skrajša na osem šestnajstiških znakov, podobnega raziskovalnega preboja ne potrebujemo. Verjetnost ujemanja lahko ocenimo že z matematičnim načelom, ki pojasnjuje, zakaj imata v skupini 23 ljudi dva tako pogosto rojstni dan na isti datum.
Pri rojstnih dnevih takšno ujemanje nikogar ne zavede, da gre za isto osebo. Datum rojstva je samo ena od njenih lastnosti in sam zase ne zadostuje za zanesljivo identifikacijo. Informacijski sistem pa lahko enak skrajšani odtis razume kot ukaz, naj dokument zavrne, preskoči ali poveže z drugim zapisom. Če njegov postopek ne predvideva možnosti trka, bo tudi dve različni datoteki obravnaval kot eno.
EVIDENCE PROFILE
Dokazni profil članka
Profil pokaže vrsto dokazne podlage in omejitve osrednjega argumenta.
Viri
- 01STANDARDNational Institute of Standards and Technology (NIST)NIST – Recommendation for Applications Using Approved Hash Algorithms, SP 800-107 Rev. 1, avgust 2012. Tehnična podlaga za odpornost proti trkom, napade na predslike in skrajševanje zgoščenih vrednosti. NIST je leta 2022 napovedal umik publikacije in prenos relevantnih zahtev v druga navodila; na strani publikacije je navedena kot končna različica z opombo o načrtovanem umiku. https://csrc.nist.gov/pubs/sp/800/107/r1/finalOdpri vir ↗
- 02PRIMARY DOCUMENTATIONGoogleGoogle Security Blog – Announcing the First SHA1 Collision, 23. februar 2017. Prvotna objava sodelovanja Google–CWI, tehničnega rezultata SHAttered in podatkov o računski zahtevnosti napada. https://security.googleblog.com/2017/02/announcing-first-sha1- collision.htmlOdpri vir ↗
- 03PRIMARY RESEARCHUSENIXLeurent, G. in Peyrin, T. – SHA-1 is a Shambles: First Chosen- Prefix Collision on SHA-1 and Application to the PGP Web of Trust, USENIX Security Symposium, 2020. Recenzirana raziskava praktičnega napada z izbranima predponama in njegove uporabe pri certifikacijskih podpisih PGP. https://www.usenix.org/conference/usenixsecurity20/presentation/le urentOdpri vir ↗
- 04STANDARDNational Institute of Standards and Technology (NIST)NIST – Transitioning Away from SHA-1 for All Applications, 15. december 2022. Uradna objava prehodnega načrta in časovnice umika SHA-1. https://www.nist.gov/news-events/news/2022/12/nist-transitioning- away-sha-1-all-applicationsOdpri vir ↗
- 05STANDARDNational Institute of Standards and Technology (NIST)NIST – Policy on Hash Functions. Uradna priporočila o SHA-1, SHA-2 in SHA-3 ter razlikovanju med posameznimi kriptografskimi uporabami. https://csrc.nist.gov/projects/hash-functions/nist-policy-on-hash- functions Metodološka opomba: Verjetnosti, navedene pri rojstnih dnevih in 32- bitnih odtisih, so matematični izračuni ob predpostavkah neodvisnosti in enakomerne porazdelitve. Opisana dokumentna aplikacija je hipotetičen primer, ne poročilo o dejanskem varnostnem incidentu.Odpri vir ↗