Kibernetska varnost in napadi
NAPAD NA PRESOJO
Ko se napad začne pri načinu, kako računalnik vidi vsebino
Beseda funding je lahko na zaslonu videti povsem običajno.
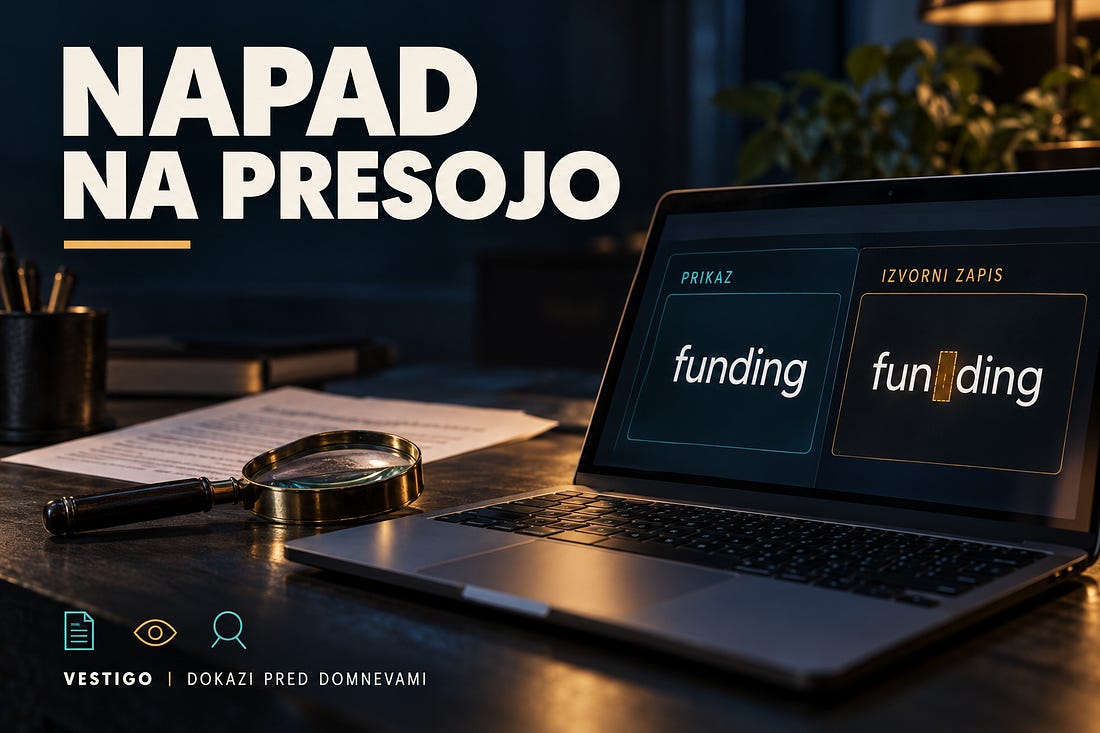
Človek jo prebere in ne opazi nič posebnega. V zapisu pa je mogoče med črke vstaviti znak, ki ga uporabniški vmesnik ne prikaže. Za bralca ostane beseda enaka, programska oprema pa lahko prejme drugačno zaporedje znakov.
Microsoftovi raziskovalci so leta 2026 takšno tehniko zaznali v obsežni kampanji neželene in lažne elektronske pošte. Napadalci so v finančne izraze vstavljali nevidne znake iz območja Unicode Tags. Namen ni bil skriti dodatnega sporočila ali celotne vsebine. Dovolj je bilo prekiniti besedo na mestu, ki ga človek ni videl, programska obdelava pa ga je lahko zaznala.
Primer sega precej dlje od elektronske pošte. Povsod, kjer med človeka in rezultat vstopi avtomatizirana analiza, moramo vedeti, kaj je naprava dejansko dobila v obdelavo.
Isto sporočilo, različni zapisi
Zaslon pokaže eno obliko podatka. Programska oprema lahko v ozadju obdeluje drugo.
Pri vsakdanjem delu te razlike skoraj ne opazimo. Črke se prikažejo kot črke, dokument kot dokument in sporočilo kot sporočilo. Zato zlahka predpostavimo, da računalnik obdeluje natančno tisto, kar vidimo.
Med izvorno vsebino in končnim rezultatom pa so lahko dekodiranje, normalizacija znakov, pretvorba dokumenta, ekstrakcija besedila, parser, OCR, tokenizacija ali klasifikacijski model. Vse rešitve nimajo vseh teh korakov. Že ena sama pretvorba je dovolj, da se tisto, kar vidi človek, razlikuje od vhoda, ki ga prejme naslednja komponenta.
Microsoft je med drugim opisal primer, v katerem je bil nevidni znak U+E0020 vstavljen v sredino finančnega izraza. Človek je še vedno videl običajno besedo. Preprost iskalni vzorec pa ni več nujno dobil neprekinjenega zaporedja črk, ki ga je pričakoval. Spremeni se lahko tudi tokenizacija.
Pomen za človeka ostane enak. Spremeni se zapis, ki ga obdela programska oprema.
Tehnike besedilne obfuskacije niso nove. Nevidni znaki, mehki vezaji, podobni znaki iz različnih pisav in druge oblike zapisovanja se uporabljajo že dolgo. Posebnost konkretnega primera je predvsem njegov obseg.
Microsoftova telemetrija je 8. februarja 2026 zaznala približno 21.000 takšnih sporočil. Naslednji dan jih je bilo več kot 1,3 milijona, 11. februarja pa več kot 2,3 milijona. Povišana dejavnost je trajala več mesecev in izrazito upadala ob koncih tedna.
Številke povedo, kako razširjena je bila tehnika. Mehanizem pa pokaže nekaj pomembnejšega.
Človek bere prikazano besedilo. Filter lahko išče določeno zaporedje znakov, druga zaščitna plast ocenjuje povezave, domeno ali ugled pošiljatelja, jezikovni model pa vsebino razdeli v tokene. Gre za isti dogodek, vendar ne nujno za isto obliko njegovega zapisa.
Prav v tej razliki se lahko pojavi prostor za manipulacijo.
Ko postane tarča tudi analitik
Podoben problem se pojavlja pri uporabi jezikovnih modelov za analizo programske kode.
Konec avgusta 2026 je ESET opozoril na primer zlonamerne VBScript datoteke, povezane z akterjem UAC-0099. V komentarju kode je bilo vstavljeno varnostno občutljivo besedilo. Komentar med izvajanjem skripte nima naloge in ga interpreter lahko prezre.
Za jezikovni model, ki prejme celotno datoteko, pa je komentar del vhodnega konteksta.
ESET je pojav poimenoval GuardBreaker. Po njihovi razlagi naj bi bil namen besedila sprožiti varnostne omejitve modela in tako otežiti ali prekiniti AI-podprto analizo zlonamerne kode. Pri tem je treba ločiti, kaj je dejansko dokazano. Obstoj artefakta je dokumentiran, prav tako ESET-ova razlaga njegovega namena. Precej manj javnih dokazov pa je o dejanski učinkovitosti tehnike. Objavljena ni bila primerjalna meritev, iz katere bi lahko sklepali, kateri modeli so bili prizadeti, kako pogosto bi analiza odpovedala ali ali je bila v konkretnem primeru sploh uspešno ustavljena.
Iz poskusa napada zato ne moremo avtomatično narediti dokaza o njegovem uspehu.
Podobne zamisli so se pojavile že prej. V tem primeru je zanimivejše nekaj drugega: v analitični verigi ima vse večjo vlogo še en opazovalec. Z njim se odpira tudi dodatna površina za manipulacijo.
Težava se lahko začne pred pravilom
Pri avtomatizaciji pogosto preverjamo kakovost pravila, natančnost modela, nastavljeni prag ali končni rezultat zaznave. Toda odpoved se lahko začne še pred tem.
Predstavljajmo si filter, ki pravilno blokira vsako sporočilo z določenim izrazom. Če vhodna obdelava zaradi nevidnega znaka temu filtru ne posreduje pričakovanega zaporedja črk, pravilo ne dobi tistega, za kar je bilo napisano.
Takrat ni nujno narobe pravilo. Težava je lahko v poti do njega.
Podobno lahko jezikovni model povsem pravilno sledi svojim varnostnim omejitvam. Če nepreverjena vsebina znotraj analiziranega artefakta začne vplivati na kontekst analize, se meja med podatkom in navodilom zabriše.
To je drugačen tip napada. Napadalec ne poskuša vedno premagati odločitve. Lahko spremeni predmet, nad katerim se odločitev izvede.
Normalizacija pomaga, vendar ni dovolj sama po sebi
Pri nevidnih znakih obstaja razmeroma neposreden obrambni ukrep.
Microsoft priporoča normalizacijo ali odstranjevanje nevidnih in nerenderiranih znakov pred uporabo podpisov, regularnih izrazov in podobnih preverjanj. Njihova prisotnost je lahko tudi dodaten signal za zaznavanje anomalij.
Vendar preprosto brisanje vseh nenavadnih znakov ni dobra splošna rešitev. Nekateri imajo legitimno uporabo, različne aplikacije pa lahko uporabljajo različna pravila normalizacije. Vsebina se lahko med obdelavo večkrat prekodira. Dokument lahko ena komponenta bere kot HTML, druga kot besedilo, tretja kot sliko in četrta kot zaporedje tokenov.
Zato mora biti vhod v odločanje nadzorovan enako skrbno kot sam mehanizem odločanja.
Pri klasični informacijski varnosti je to že dolgo del validacije vhodnih podatkov. Pri sistemih umetne inteligence se isto vprašanje vrača v nekoliko drugačni obliki. Vsebina, ki jo analiziramo, ne sme neopazno dobiti vloge navodila samo zato, ker je zapisana v istem kontekstu.
Microsoftov primer pokaže tudi korist večplastnega preverjanja. Več kot 99 odstotkov sporočil iz opisane dejavnosti so zaznale tudi druge zaščitne plasti, ki niso bile odvisne samo od prepoznavanja spornih Unicode znakov. Upoštevale so ugled pošiljateljev in domen, povezave, značilnosti neželene pošte ter druge signale.
Vrednost takšnega pristopa ni zgolj v številu kontrol. Pomembno je, da posamezne plasti opazujejo različne lastnosti istega dogodka. Če ena spregleda manipulacijo v zapisu besede, jo lahko druga odkrije skozi vedenje pošiljatelja, povezavo ali drug neodvisen signal.
Revizijska sled mora pokazati tudi vhod
Pri avtomatiziranih procesih običajno hranimo predvsem končni status. V evidenci lahko ostane zapis, da je bilo sporočilo označeno kot varno, dokument razvrščen v določeno kategorijo, zahteva sprejeta ali analizator ni zaznal težave.
Tak zapis pove, kaj se je zgodilo na koncu. Pogosto pa ne omogoča rekonstrukcije tega, kar je posamezna komponenta dejansko obdelovala.
Izvirni dokument ni nujno enak ekstrahiranemu besedilu. Ekstrahirano besedilo se lahko razlikuje od normalizirane različice, ta pa od tokenov, ki jih prejme model. Prikaz uporabniku je lahko še ena različica istega artefakta.
Če hranimo samo končni rezultat, lahko pozneje preverimo, kaj je orodje odločilo. Veliko težje ugotovimo, na kateri različici vhodnih podatkov je odločitev temeljila.
Kjer je tveganje dovolj veliko, mora biti mogoče rekonstruirati vsaj ključne dele poti:
izvorni artefakt → SHA-256 → pretvorba → dejanski vhod analize → različica mehanizma → rezultat
Ni smiselno, da bi vsak informacijski sistem hranil vsako vmesno stanje za vedno. Takšna rešitev bi bila pogosto nepraktična. Brez dovolj podatkov o vhodu pa lahko pozneje preverimo predvsem rezultat, ne pa zanesljivo tudi njegove podlage.
Pred odločitvijo je še ena plast
Nevidni znak v elektronskem sporočilu in komentar v zlonamerni skripti sta majhna tehnična primera. Skupno jima je, da opozarjata na plast med izvirnikom in končno analizo, ki jo človek pogosto sploh ne vidi. V tej plasti se vsebina pretvarja, normalizira, razčlenjuje in pripravlja za nadaljnjo obdelavo. Dokler vse deluje pričakovano, ostane skoraj nevidna. Ko nekdo začne namerno iskati razlike med posameznimi zapisi istega artefakta, postane del napadalne površine.
Zato ni dovolj preveriti samo končnega rezultata.
Preden preverimo odločitev, moramo vedeti, kaj je sistem dejansko presojal.
EVIDENCE PROFILE
Dokazni profil članka
Profil pokaže vrsto dokazne podlage in omejitve osrednjega argumenta.
Viri
- 01ADVISORYMicrosoftMicrosoft Security Research, Noam Kochavi in Sarah Wolstencroft. ASCII smuggling crosses over from AI prompt injection to phishing evasion. Microsoft Security Blog, 3. september 2026.
- 02SECONDARYThe Hacker NewsRavie Lakshmanan. Russia-Aligned UAC-0099 Plants Nuclear Weapon Prompt in Malware to Disrupt AI Analysis. The Hacker News, 1. september 2026. Članek povzema ugotovitve in objave ESET Research o dejavnosti UAC-0099 ter pojavu GuardBreaker.
- 03PRIMARY DOCUMENTATIONParminder Kumar Sharma.Parminder Kumar Sharma. UAC-0099 GuardBreaker: the anti-AI prompt in malware, examined. 1. september 2026. Vir je uporabljen predvsem za preverjanje meja javno dostopnih dokazov, predhodnih podobnih primerov ter odsotnosti javno dokumentirane meritve učinkovitosti tehnike.