Umetna inteligenca in avtomatizacija
TESTIRALI SMO MODEL, NE PA SISTEMA
Kako po spremembi indeksa, dokumentov ali dovoljenj preveriti aplikacijo, ki uporablja isti jezikovni model
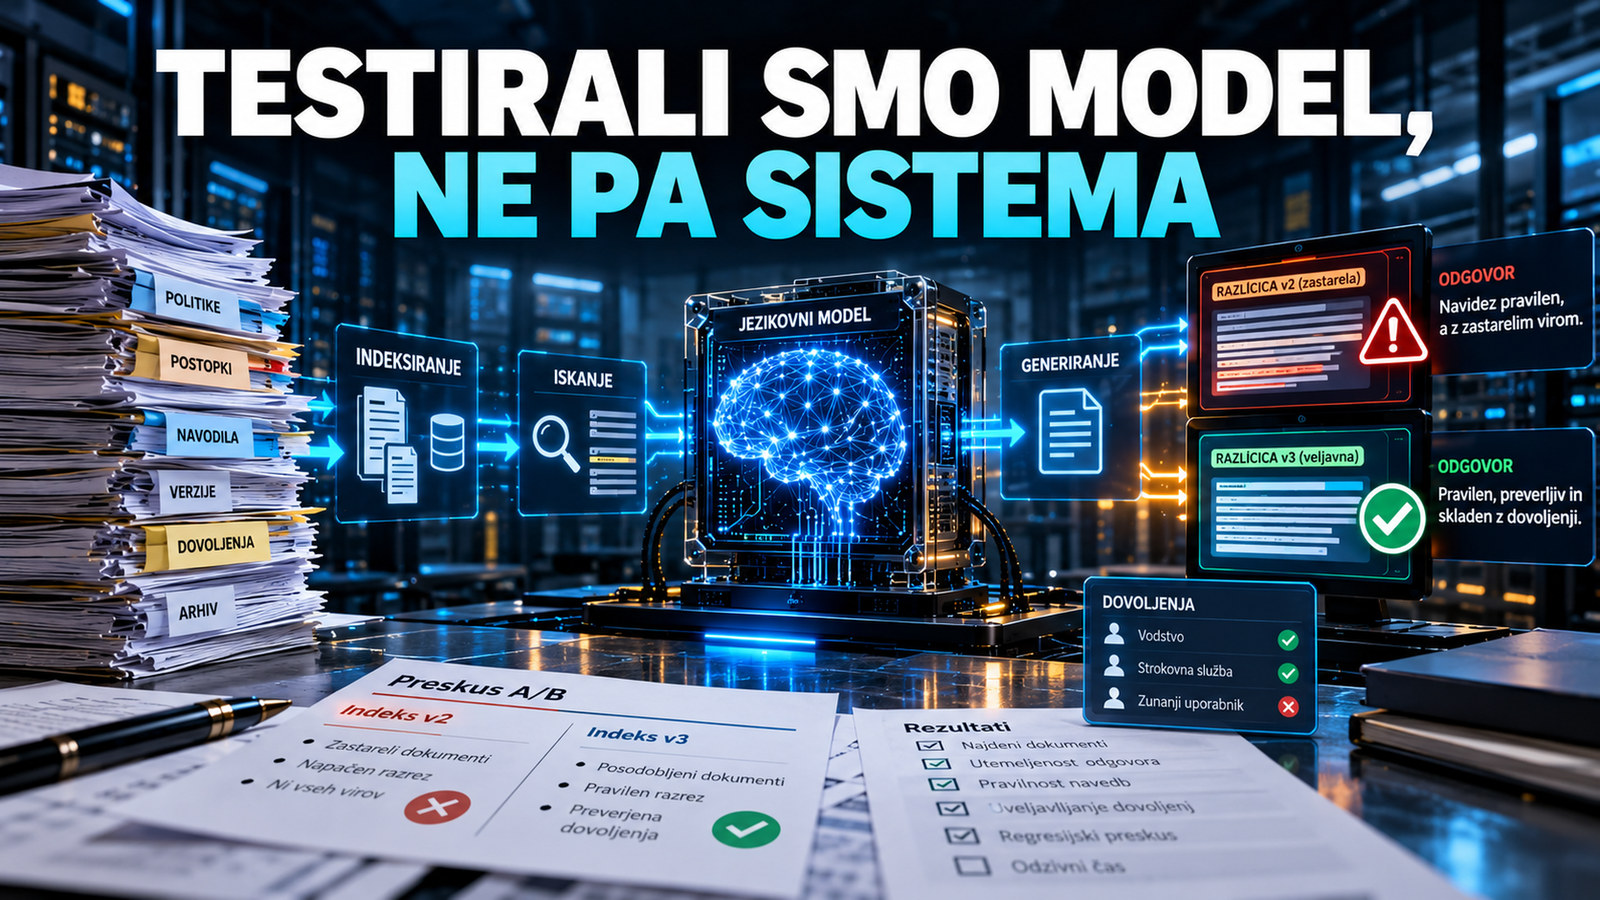
V poročilu o preskusu jezikovnega modela je vse zeleno. Model ima enako oznako, na referenčnem naboru vprašanj dosega primerljiv rezultat, predloga poziva se ni spremenila. Toda notranji iskalnik po posodobitvi uporabniku priporoči obrazec, ki že nekaj časa ne velja. Kdor pogleda samo poročilo o modelu, nima razloga za alarm; kdor odpre veljavni postopek, vidi napačen odgovor.
To je zamišljen primer, namenjen razlagi preskušanja, in ne opis incidenta ali opravljenih meritev. Njegova posebnost je v tem, da napake ni treba iskati v utežeh modela. Dovolj je, da se med izvorno dokumentacijo in modelom spremeni ena povezava: osveževanje indeksa, razdelitev besedila, izbor zadetkov ali pravilo, ki določa, katere dokumente sme dobiti posamezen uporabnik.
Kaj je bilo dejansko preskušeno
Osnovni model lahko preverjamo na standardiziranih nalogah, kjer poznamo vprašanja in način ocenjevanja. Notranji dokumentni iskalnik pa vključuje še zajem datotek, pretvorbo vsebin, metapodatke, različice dokumentov, dostopna dovoljenja, iskalnik, morebitno ponovno razvrščanje zadetkov in prikaz končnega odgovora. Meritev prvega pove nekaj o zmogljivosti izbranega modela v določenih okoliščinah; o drugi storitvi lahko sklepa le, če preskus zajame tudi njene druge sestavne dele.
Pri pristopu RAG (retrieval-augmented generation) aplikacija ob vprašanju pridobi podatke iz zunanjega korpusa in jih doda kontekstu za generiranje. Izvorno delo Lewisa in sodelavcev opisuje povezavo med generativnim modelom in pridobivanjem zunanjega znanja. V dejanski aplikaciji to pomeni več zaporednih odločitev: katero izdajo dokumenta uvoziti, kako iz nje izluščiti besedilo, kje postaviti meje odsekov, kako ustvariti vektorske predstavitve ter koliko najdenih delov poslati modelu. [1]
Napaka se lahko pojavi že pri pretvorbi preglednice, če izpade opomba, ki omejuje veljavnost pravila. Drugič se pri osveževanju indeksa ohrani stara izdaja dokumenta ali pa sprememba razreza loči izjemo od pogoja, na katerega se nanaša. Tudi pravilno najden odsek ni zagotovilo, da ga bo model uporabil: raziskava Lost in the Middle je pri proučevanih modelih in nalogah pokazala, da lahko položaj informacije v daljšem kontekstu vpliva na rezultat. Njene ugotovitve niso univerzalna napoved vedenja vseh modelov. [4]
Regresija med izvorom in odgovorom
Za preskus določimo dva dokumenta. Postopek v2 je nekoč predpisoval obrazec A, veljavni v3 pa obrazec B. Oba sta ohranjena v izvornem repozitoriju. Preskusna oseba ima dovoljenje za branje obeh izdaj in vpraša: »Kateri obrazec uporabim pri izredni nabavi?« Področni strokovnjak je vnaprej potrdil, da mora odgovor izhajati iz v3, iz odstavka o izredni nabavi.
Konfiguracija A ima ta odstavek v indeksu pod identifikatorjem v3/§4. Konfiguracija B uporablja isti model, enako vprašanje in enak poziv, vendar po spremembi uvoza veljavni odstavek ni več indeksiran. Med najdenimi zadetki ostane v2/§4. Model, ki iz takega konteksta napiše »obrazec A«, je lahko povsem zvest prejetemu besedilu, odgovor storitve pa je še vedno napačen. Skušati bi moral prepoznati nezadostno podlago ali zastarelo izdajo, toda uspeha tega varovala ni dovoljeno predpostaviti.
| Podatek preskusa | Konfiguracija A | Konfiguracija B |
|---|---|---|
| Izvorni repozitorij | v3 je prisoten | v3 je prisoten |
| Veljavni odsek v indeksu | v3/§4 | manjka |
| Odsek, izbran za kontekst | v3/§4 | v2/§4 |
| Model, poziv in dovoljenja | nespremenjeni | nespremenjeni |
| Kaj mora ugotoviti preskus | ali je odgovor pravilen in sledljiv | ali je sistem zavrnil odgovor ali podal zastarel podatek |
Tabela opisuje zasnovo hipotetičnega primerjalnega preskusa. Izidov ni izmerila nobena produkcijska ali laboratorijska namestitev.
Primerjavo je treba voditi previdno. Enako ime gostovanega modela še ne zagotavlja nespremenjene notranje izdaje; kjer je mogoče, zabeležimo njen natančen identifikator. Shraniti je treba tudi nastavitve generiranja in različico pozivne predloge. Ob nedeterminističnem vedenju opravimo ponovitve, izginotje odseka v3/§4 iz indeksa pa je mogoče dokazati neposredno, brez ugibanja o modelovem notranjem sklepanju.
Drugačen preskus uporabi isti korpus, vendar spremeni razrez. Pogoj »če vrednost presega odobreni prag« ostane v enem odseku, navodilo o obrazcu pa v drugem; iskalnik v kontekst pošlje samo drugi del. Na ravni seznama uvoženih dokumentov je vse videti nespremenjeno. Razliko razkrijejo šele meje odsekov, zadetki in dejansko sestavljeno besedilo, posredovano modelu.
Povezava do vira ni isto kot sled uporabljenega odseka
Vprašanje, ali navedeni vir res podpira trditev, je Vestigo že obravnaval pri javnih iskalnikih z umetno inteligenco. Tu gre za dodatno preverjanje znotraj aplikacije. Preskuševalec mora znati povezati trditev z identifikatorjem pridobljenega odseka, različico dokumenta in končnim URL-jem, ki ga uporabnik vidi pod odgovorom. Če oba postopka nosita enak naslov, lahko povezava kaže na novega, medtem ko je model dobil starega.
Pri analizi zato potrebujemo vsaj dva pogleda. Prvi je sled iskanja: identifikatorji dokumentov, različice, vrnjeni odseki, vrstni red in natančen kontekst za model. Drugi je uporabniški izid: surovo generirano besedilo, njegovo poznejše oblikovanje in cilji prikazanih povezav. Tako lahko ločimo vsebinsko izmišljanje modela od napake pri izboru gradiva ali pri pripenjanju citata. Skupna ocena »odgovor je utemeljen« teh razlik sama ne pokaže.
NIST AI 600-1 v ukrepu MS-2.5-003 priporoča preverjanje virov in citatov pred uvedbo in pri nadaljnjem spremljanju. Ukrep MS-2.5-005 se nanaša tudi na dokazovanje izvora podatkov za preskušanje ter utemeljenost gradiva pri RAG. Gre za priporočila prostovoljnega okvira, ki jih je treba prilagoditi konkretni storitvi. [5]
Iskanje ima svojo mejo dovoljenj
Drugi negativni primer preverja uporabnika brez dostopa do kadrovske dokumentacije. Dokument je del skupnega vektorskega indeksa, aplikacija pa omejitev preveri šele po širšem iskanju. Končni odgovor lahko ostane brez zaupnih podatkov, vendar seznam zadetkov, njihove ocene, število rezultatov ali razlike v odzivnem času v določenih zasnovah omogočijo sklepanje o obstoju zaščitene vsebine. Zato sam pogled na končni odgovor ni ustrezen preskus avtorizacije.
OWASP v izdaji Top 10 for LLM Applications 2026 takšna tveganja obravnava pod LLM09:2026 – Vector and Embedding Weaknesses; širše kanale razkrivanja občutljivih podatkov obravnava LLM02:2026 – Sensitive Information Disclosure. Pri zasnovi z vektorskim iskanjem je pomembno, da se dovoljen obseg zbirke uveljavi v zaupanja vredni strežniški poti že pri poizvedbi oziroma pred razkritjem podatkov, ne zgolj z naknadnim odstranjevanjem besedila iz odgovora. Izbira med ločenimi indeksi in preverjenim filtriranjem je odvisna od arhitekture in zahtev izolacije. [6][7]
Preskus z dvema vlogama mora zato preveriti več kot različna stavka na zaslonu. Za vsako vlogo se zabeležijo učinkovita dovoljenja, obseg poizvedbe, dejansko pridobljeni odseki in poti, po katerih jih je mogoče ponovno odpreti. Preveriti je treba tudi predpomnilnike in neposredne povezave, zlasti po preklicu dovoljenja. Navodilo modelu, naj zaupnih informacij ne razkrije, ne nadomešča preverjanja pravic v aplikaciji in podatkovnih storitvah.
Preskusni nabor mora vsebovati tudi neprijetna vprašanja
Pri demonstraciji običajno izberemo naloge, za katere imamo gradivo. Sprejemni preskus potrebuje še položaje, ko veljavnega vira ni, ko je izpadel iz indeksa, ko je odgovor odvisen od manjkajočega pogoja in ko obstaja dokument, ki ga uporabnik ne sme dobiti. Ti štirje primeri imajo različen vzrok. V prvem bi bila primerna zadržanost, pri drugem je treba raziskati osveževanje, pri tretjem zahtevati pojasnilo, četrti pa zahteva varnostno preverjanje, ki ne razkrije obstoja zaščitenega gradiva.
V isti nabor vključimo poškodovano tabelo, zastarelo pravilo, napačno preslikan citat, zavajajoče relevanten odsek in preklic dovoljenja med uporabo. Koristen je tudi en preskus z nezaupljivim dokumentom, ki vsebuje navodila za model; njegov namen je preveriti mejo zaupanja pri obdelavi vsebine. Splošna razlaga posrednega napada s pozivom spada drugam. Za vsak scenarij vnaprej opredelimo dopusten odgovor, pogoje za zavrnitev in dogodek, ki pomeni neuspeh preskusa.
Pri pripravi referenčnega nabora sodelujeta vsebinski strokovnjak in odgovorna oseba za dostopna dovoljenja. Strokovnjak ugotovi, katera izdaja podpira pravilno rešitev; skrbnik dostopov potrdi, katere dokaze sme preskusna identiteta dejansko prejeti. Če uporabnik za dokument nima pravic, ga pri ocenjevanju iskanja ne smemo šteti med zahtevane dovoljene zadetke, morebitno razkritje pa vseeno obravnavamo kot ločen varnostni neuspeh.
Kaj povedo meritve in česa ne
Pri prvih k zadetkih je precision@k delež relevantnih odsekov med vrnjenimi; recall@k pa delež vseh vnaprej označenih relevantnih dovoljenih odsekov, ki so se znašli med temi zadetki. Ocena nDCG@k dodatno upošteva vrstni red in ocenjeno stopnjo relevantnosti. Teh meril ne smemo zamenjevati: iskalnik lahko ponudi nekaj izjemno primernih odsekov, a izpusti prav tistega, ki vsebuje veljavno izjemo. Brez referenčnega nabora in opredelitve relevantnosti tudi izračun priklica ni razložljiv.
Za generiranje ločeno preverjamo, ali so trditve podprte s podanim kontekstom, ali so pravilne glede na veljavni izvirnik ter ali so zavrnitve primerne. Dodati je treba pravilnost citatov in njihovih povezav, delež varnostno nedovoljenih pridobitev, napake pri osveževanju in odzivni čas. RAGAS in ARES sta raziskovalni izhodišči za večdimenzionalno vrednotenje aplikacij RAG; ocenjevalci lahko skrajšajo ročno delo, vendar njihove sodbe zahtevajo preverjanje na ustrezno označenih primerih. [2][3]
Za izdajo ni univerzalnega sprejemnega odstotka, ki bi ga predpisovala NIST ali OWASP. Organizacija mora pragove in posledice neuspeha vezati na uporabo storitve. Posebno strogo lahko določi pravilo, da potrjeno nedovoljeno razkritje zadrži uvedbo, čeprav je povprečna ocena odgovorov visoka. Nič zaznanih razkritij v omejenem preskusnem naboru še ni dokaz, da je sistem varen v vseh okoliščinah.
Zapis, iz katerega je mogoče ponoviti napako
Za vsako vprašanje potrebujemo oznako primera, čas, preskusno vlogo, pričakovani odgovor in veljavno izdajo izvornega dokumenta. Poleg tega zabeležimo posnetek korpusa, datum indeksiranja, različico pretvornika, parametre razreza in vektorskega modela, iskalne filtre, vrnjene odseke ter morebitno ponovno razvrstitev. Zaključni del sledi vsebuje sestavljeni kontekst, izdajo modela, parametre generiranja, surovi rezultat in tisto, kar je aplikacija nazadnje dejansko prikazala.
Takšen zapis je treba varovati, saj lahko vsebuje dele zaupnih dokumentov in uporabniške identifikatorje. Kjer je mogoče, zadostuje zaščitena referenca ali zgoščeni odtis; če je za ponovitev potrebno besedilo, ga hranimo z omejenim dostopom in določenim rokom. Namen preskusne sledi je omogočiti ugotovitev vzroka, ne ustvariti druge, slabše varovane kopije dokumentnega sistema.
NIST AI RMF 1.0 in profil za generativno umetno inteligenco ponujata okvir za upravljanje ter merjenje tveganj. Priročnik NIST AI 200-3, objavljen septembra 2026, vrednotenje aplikacij povezuje s preskušanjem modelov, napadalnim preskušanjem in preskušanjem z uporabniki. Nobeden od teh dokumentov sam po sebi ne potrjuje kakovosti določenega iskalnika; določa uporabna izhodišča za načrtovanje dokazov, ki jih je treba zbrati na konkretnem sistemu. [5][8][9]
Pred uvedbo je zato odločilno, ali lahko iz zapisov dveh izdaj pojasnimo, zakaj se je odgovor spremenil. Če najdemo trenutek, ko je veljavni odsek izginil iz indeksa, ko je filter spustil nedovoljen dokument ali ko je prikaz pokazal napačno povezavo, imamo podlago za popravek. Sam nespremenjen rezultat jezikovnega modela nam pri takšni napaki ne pomaga prav veliko.
EVIDENCE PROFILE
Dokazni profil članka
Profil pokaže vrsto dokazne podlage in omejitve osrednjega argumenta.
Viri
- 01PRIMARY RESEARCHNeurIPS / Lewis in sod.Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Lewis idr. (2020), izvirna raziskava pristopa RAG, NeurIPS 2020.
Odpri vir ↗ - 02PRIMARY RESEARCHACL Anthology / EACLRAGAs: Automated Evaluation of Retrieval Augmented Generation
Es, James, Espinosa-Anke in Schockaert (2024), EACL 2024, System Demonstrations, str. 150–158.
Odpri vir ↗ - 03PRIMARY RESEARCHACL Anthology / NAACLARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems
Saad-Falcon, Khattab, Potts in Zaharia (2024), NAACL 2024.
Odpri vir ↗ - 04PRIMARY RESEARCHACL Anthology / TACLLost in the Middle: How Language Models Use Long Contexts
Liu idr. (2024), Transactions of the Association for Computational Linguistics.
Odpri vir ↗ - 05STANDARDNISTArtificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1)
NIST (2024); v članku zlasti ukrepi MS-2.3-001, MS-2.5-001, MS-2.5-003 in MS-2.5-005. Prostovoljni okvir.
Odpri vir ↗ - 06PRIMARY DOCUMENTATIONOWASP GenAI Security ProjectLLM09:2026 – Vector and Embedding Weaknesses
OWASP Top 10 for LLM Applications, izdaja 2026.
Odpri vir ↗ - 07PRIMARY DOCUMENTATIONOWASP GenAI Security ProjectLLM02:2026 – Sensitive Information Disclosure
OWASP Top 10 for LLM Applications, izdaja 2026.
Odpri vir ↗ - 08PRIMARY DOCUMENTATIONNISTARIA Evaluation Planning Manual: Elements of ARIA-Style AI Evaluations (NIST AI 200-3)
Jensen idr. (2026); uradni podatki publikacije in datum objave 18. septembra 2026; DOI: 10.6028/NIST.AI.200-3.
Odpri vir ↗ - 09STANDARDNISTArtificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1
NIST (2023), okvir za upravljanje tveganj umetne inteligence.
Odpri vir ↗